Équité, Diversité et Inclusion
dans les systèmes de recommandation socialeEquity, Diversity and Inclusion
in social recommender systems
Ce tableau de bord présente une méthode originale basée sur le coarsening de graphe pour améliorer simultanément l'équité (ΔE), la diversité (ILD) et l'inclusion dans les listes de recommandation — validée sur 4 corpus distincts (5 jeux de données au total, MovieLens étant testé à deux échelles).This dashboard presents an original method based on graph coarsening to simultaneously improve equity (ΔE), diversity (ILD) and inclusion in recommendation lists — validated on 4 distinct corpora (5 datasets in total, MovieLens being tested at two scales).
Les règles d'agrégation classiques — Borda, Condorcet, Average Score — n'ont aucun mécanisme pour éviter de favoriser les groupes majoritaires, d'homogénéiser les listes ou de sous-représenter les minorités. Ce travail propose une alternative : un coarsening de graphe sous contraintes EDI qui intègre l'équité directement dans la structure, plutôt que de la corriger après coup.Classical aggregation rules — Borda, Condorcet, Average Score — have no mechanism to avoid favoring majority groups, homogenizing lists, or under-representing minorities. This work proposes an alternative: an EDI-constrained graph coarsening that embeds equity directly into the structure, rather than correcting it after the fact.
Notre méthode améliore simultanément les 4 métriques EDI (ΔE ↓, ILD ↑, inc_F ↑, inc_M ↑) par rapport à Borda et Condorcet — sur MovieLens 100k à k=20 (Weighted Borda y parvient aussi en repondérant explicitement ses scores par la taille des groupes ; AURORA l'obtient sans reformuler la règle de vote, par contrainte structurelle pendant la fusion du graphe). Sur Rate My Professors, elle atteint ILD = 0.808 contre 0.267 pour Borda — soit environ 3× plus de diversité, avec la meilleure représentation (frac_F=0.60). Sur libimseti.cz, aucune amélioration : les patterns de notation diffèrent significativement selon la paire de genres (notateur, noté), une limite structurelle documentée dans l'onglet libimseti.cz (ΔE > 1.0 pour les méthodes de vote — Borda, Weighted Borda, Condorcet — ainsi que pour AURORA ; Average Score et Fair Re-rank y échappent en ne créant aucune différenciation par groupe). Sur OpenAlex, elle obtient le meilleur ΔE = 0.031 — seule méthode à réduire le biais de genre académique tout en maintenant la diversité.Our method simultaneously improves all 4 EDI metrics (ΔE ↓, ILD ↑, inc_F ↑, inc_M ↑) over Borda and Condorcet — on MovieLens 100k at k=20 (Weighted Borda also achieves this by explicitly reweighting its scores by group size; AURORA gets there without reformulating the voting rule, through a structural constraint during graph merging). On Rate My Professors, it reaches ILD = 0.808 versus 0.267 for Borda — roughly 3× more diversity, with the best representation (frac_F=0.60). On libimseti.cz, no improvement: rating patterns differ significantly by gender pair (rater, rated), a structural limitation documented in the libimseti.cz tab (ΔE > 1.0 for the voting methods — Borda, Weighted Borda, Condorcet — as well as for AURORA; Average Score and Fair Re-rank escape this only because they create no group differentiation at all). On OpenAlex, it achieves the best ΔE = 0.031 — the only method that reduces academic gender bias while maintaining diversity.
Pipeline vérifié bout-en-bout sur les 5 datasets. Code source disponible sur demande auprès de l'auteure.Pipeline verified end-to-end on all 5 datasets. Source code available upon request from the author.
MovieLens 100k est inclus dans data/. Les jeux ML-1M, libimseti et RMP (volumineux) sont exclus du dépôt (.gitignore) — voir le README pour leurs sources. Les résultats de chaque run alimentent directement les JSON affichés dans ce dashboard.MovieLens 100k is included in data/. The ML-1M, libimseti, and RMP datasets (large) are excluded from the repo (.gitignore) — see the README for their sources. Each run's results directly feed the JSON files displayed in this dashboard.
Users : 943 (100k) · 6 040 (1M)
Items : 1 682 · 3 706 filmsmovies
Ratings : 100k · 1M notesratings (1–5)
ÉquitéEquity : Genre des notateurs (F/M)Gender of raters (F/M)
α_F : 29% (100k) · 28% (1M)
Users : 1 000 (500F / 500M)
Items : 32 677 profils (avec genre)profiles (with gender)
Ratings : 97 707 notesratings (1–10)
ÉquitéEquity : Genre des rateurs (F/M)Gender of raters (F/M)
θ : 7.0 (80% sur l'échelle 1–1080% on the 1–10 scale)
Users : 1 981 cours (ex. ENG101)courses (e.g. ENG101)
Items : 59 066 professeursprofessors
Ratings : 150 800 notesratings (1–5)
ÉquitéEquity : Genre des profs recommandésGender of recommended professors
α_F : 51% des profs51% of professors
Users : ~99 venues (NeurIPS, ICML)
Items : ~900 auteursauthors AI/ML/CS
Ratings : ~2 100 associationsco-authorships (2018–2023)
ÉquitéEquity : Genre des auteurs recommandésGender of recommended authors
α_F : 19% des auteurs (genre connu)19% of authors (known gender)
* libimseti : 500F/500M par construction (échantillonnage stratifié). OpenAlex : genre estimé par prénom (Genderize.io), 19% F car l'AI/ML reste très masculin.* libimseti: 500F/500M by construction (stratified sampling). OpenAlex: gender estimated from first name (Genderize.io), 19% F because AI/ML remains heavily male-dominated.
MovieLens valide la méthode sur un cas classique (user-side, notes 1–5). libimseti teste la robustesse avec un fort biais de genre (ΔE > 1 pour Borda). Rate My Professors introduit l'item-side equity — le genre des items recommandés. OpenAlex applique ce même cadre au domaine académique, où le biais de genre dans les citations est un problème connu. Cette diversité de domaines montre que le coarsening de graphe est une approche généraliste.MovieLens validates the method on a classic case (user-side, 1–5 ratings). libimseti tests robustness under a strong gender bias (ΔE > 1 for Borda). Rate My Professors introduces item-side equity — the gender of the recommended items. OpenAlex applies this same framework to the academic domain, where citation gender bias is a known problem. This diversity of domains shows that graph coarsening is a generalist approach.
| Corpus | DomaineDomain | Biais mesuré côtéBias measured on the | Intensité du biaisBias intensity |
|---|---|---|---|
| MovieLens 100k / 1M | FilmsMovies | UtilisateurUser | ModéréeModerate |
| libimseti.cz | RencontresDating | Utilisateur (des deux côtés)User (both sides) | Modérée à élevéeModerate to high |
| Rate My Professors | ÉducationEducation | Item | ModéréeModerate |
| OpenAlex | Recherche académiqueAcademic research | Item | Extrême (19% F)Extreme (19% F) |
Ensemble, les 4 corpus couvrent la diagonale complète : domaine, côté du graphe où le biais se loge, et sévérité du déséquilibre — de quoi vérifier qu'AURORA généralise plutôt que de sur-performer sur un seul cas favorable.Together, the 4 corpora cover the full diagonal: domain, the side of the graph where the bias sits, and the severity of the imbalance — enough to verify that AURORA generalizes rather than over-performing on a single favorable case.
MovieLens — la comparabilitéMovieLens — comparability
Le benchmark standard du domaine RecSys : n'importe quel relecteur peut confronter ces résultats à des dizaines d'autres papiers publiés. Les deux échelles (943 et 6 040 utilisateurs) répondent par avance à la question systématique « et à l'échelle, ça tient ? ».The standard benchmark of the RecSys field: any reviewer can compare these results against dozens of other published papers. The two scales (943 and 6,040 users) pre-emptively answer the systematic question "does it hold at scale?".
libimseti.cz — l'honnêteté qui rend le papier crédiblelibimseti.cz — the honesty that makes the paper credible
Un papier où la méthode gagne partout est suspect. En montrant un cas où AURORA n'améliore rien — et en l'expliquant par la théorie (Yao & Huang, 2017, sur les limites de la parité démographique) — cette faiblesse assumée devient une preuve de rigueur plutôt qu'un angle mort.A paper where the method wins everywhere is suspicious. By showing a case where AURORA improves nothing — and explaining it through theory (Yao & Huang, 2017, on the limits of demographic parity) — this acknowledged weakness becomes proof of rigor rather than a blind spot.
Rate My Professors — l'élargissement de la portéeRate My Professors — broadening the scope
Premier test de l'item-side equity : la méthode ne se limite pas à corriger un biais côté utilisateur, elle généralise à l'autre grande famille de biais. Le résultat (3× plus de diversité que Borda) est aussi le plus spectaculaire du lot.First test of item-side equity: the method isn't limited to correcting user-side bias, it generalizes to the other major family of bias. The result (3× more diversity than Borda) is also the most spectacular of the bunch.
OpenAlex — l'enjeu réelOpenAlex — the real-world stakes
Connecté à un problème documenté et concret (le sous-représentation des femmes en IA/ML), ce corpus donne au papier un impact au-delà des métriques abstraites — et produit le meilleur ΔE de toutes les méthodes testées, le résultat le plus fort à mettre en avant.Connected to a documented, concrete problem (the under-representation of women in AI/ML), this corpus gives the paper an impact beyond abstract metrics — and produces the best ΔE of all methods tested, the strongest result to lead with.
Chaque corpus répond par avance à une objection standard de relecteur — comparabilité, honnêteté sur les limites, généralité, enjeu réel — ce qui en fait une stratégie de défense du papier construite dès le choix des données.Each corpus pre-emptively answers a standard reviewer objection — comparability, honesty about limitations, generality, real-world stakes — making this a paper-defense strategy built in from the choice of data itself.
Un petit graphe biparti à 4 utilisateurs et 3 items, annoté pour lire la notation G = (U ∪ I, E, w, s), avant le graphe interactif MovieLens ci-dessous.A small bipartite graph with 4 users and 3 items, annotated to read the G = (U ∪ I, E, w, s) notation, before the interactive MovieLens graph below.
L'absence d'arête (ex. u1–i3, u3–i1) signifie que la note n'a pas été observée.A missing edge (e.g. u1–i3, u3–i1) means the rating was not observed.
CompressionCompression −50.1%
ΔE = 0.439 · ILD = 0.330
CompressionCompression −50.1%
ΔE = 0.423 · ILD = 0.391
CompressionCompression −50.1% · RatioRatio F/M 29→37%
ΔE = 0.285 · ILD = 0.462
Chaque corpus définit un graphe biparti différent. U = nœuds utilisateurs (ou venues), I = nœuds items, E = arêtes pondérées par la note. La densité mesure la fraction d'arêtes réellement présentes sur l'ensemble des paires possibles.Each corpus defines a different bipartite graph. U = user nodes (or venues), I = item nodes, E = edges weighted by rating. Density measures the fraction of edges actually present out of all possible pairs.
| CorpusCorpus | DomaineDomain | |U| | |I| | |E| | Échelle notesRating scale | DensitéDensity | ÉquitéEquity | α_F |
|---|---|---|---|---|---|---|---|---|
| MovieLens 100k | FilmsMovies | 943 | 1 682 | 100 000 | 1–5 | 6.3% | user-side | 29% |
| MovieLens 1M | FilmsMovies | 6 040 | 3 706 | 1 000 209 | 1–5 | 4.5% | user-side | 28% |
| libimseti.cz | RencontresDating | 1 000 | 32 677 | 97 707 | 1–10 | 0.3% | user-side | 50% |
| Rate My Prof. | AcadémiqueAcademic | 1 981 | 59 066 | 150 800 | 1–5 | 0.1% | item-side | 51%* |
| OpenAlex | PublicationsPublications | ~99 | ~904 | ~2 100 | 1–5 | 2.4% | item-side | 19% |
* α_F = proportion de femmes dans les items (profs recommandés), pas dans les utilisateurs. OpenAlex : rating = min(nb_papers_auteur_dans_venue, 5).* α_F = proportion of women among the items (recommended professors), not among users. OpenAlex: rating = min(author_papers_in_venue, 5).
Ces trois notions sont distinctes et peuvent être en tension : améliorer l'une peut dégrader une autre. Elles sont mesurées respectivement par ΔE, l'ILD, et inclusion_g ci-dessous.These three notions are distinct and can be in tension: improving one can degrade another. They are measured respectively by ΔE, ILD, and inclusion_g below.
4 utilisateurs (u₁ ∈ F, u₂, u₃, u₄ ∈ M — ce ratio 1F:3M reproduit le déséquilibre 29%F/71%M de MovieLens 100k) notent 3 films sur une échelle 1–5 (« — » = non noté) :4 users (u₁ ∈ F, u₂, u₃, u₄ ∈ M — this 1F:3M ratio reproduces the 29%F/71%M imbalance of MovieLens 100k) rate 3 movies on a 1–5 scale ("—" = not rated):
| UtilisateurUser | GroupeGroup | i₁ | i₂ | i₃ |
|---|---|---|---|---|
| u₁ | F | 5 | 2 | — |
| u₂ | M | 1 | 5 | 3 |
| u₃ | M | — | 4 | 5 |
| u₄ | M | 2 | 5 | 4 |
Le classement par Average Score donne i₂ (moyenne 4.0) ≻ i₃ (4.0) ≻ i₁ (2.67 — tiré vers le bas par les notes 1 et 2 des hommes). Le top-2 R = {i₂, i₃} exclut totalement i₁, le seul film que u₁ (F) a noté 5.Ranking by Average Score gives i₂ (mean 4.0) ≻ i₃ (4.0) ≻ i₁ (2.67 — dragged down by the men's ratings of 1 and 2). The top-2 R = {i₂, i₃} completely excludes i₁, the only movie u₁ (F) rated 5.
Pire : u₁ ne trouve aucun film noté ≥4 dans R → inclusion_F(R) = 0 < α_F = 0.25, alors que inclusion_M(R) = 0.83 > α_M = 0.75. L'utilisatrice F est totalement exclue des items pertinents du top-2.Worse: u₁ finds no movie rated ≥4 in R → inclusion_F(R) = 0 < α_F = 0.25, while inclusion_M(R) = 0.83 > α_M = 0.75. The F user is completely excluded from the relevant items of the top-2.
Agrégation de préférences & choix socialPreference aggregation & social choice
Roy et al. (2024) structurent le problème selon trois axes — format d'entrée, format de sortie, règle d'agrégation — et distinguent deux façons de rendre un résultat équitable : modifier les préférences en entrée, ou modifier le classement en sortie. Le théorème d'impossibilité d'Arrow rappelle qu'aucune règle ne peut satisfaire simultanément un ensemble raisonnable de critères d'équité, ce qui justifie de raisonner en termes de propriétés préservées plutôt que de règle optimale unique. Kellerhals & Peters (2024) relient le clustering proportionnel au vote multi-gagnant et montrent que trois notions d'équité (proportionnelle, individuelle, cœur transférable) peuvent être satisfaites ensemble — une analyse qui opère sur une métrique de graphe, conceptuellement proche de notre résumé de graphe sous contraintes.Roy et al. (2024) structure the problem along three axes — input format, output format, aggregation rule — and distinguish two ways of making a result fair: modifying the input preferences, or modifying the output ranking. Arrow's impossibility theorem reminds us that no rule can simultaneously satisfy a reasonable set of fairness criteria, which justifies reasoning in terms of preserved properties rather than a single optimal rule. Kellerhals & Peters (2024) connect proportional clustering to multiwinner voting and show that three notions of fairness (proportional, individual, transferable core) can be satisfied together — an analysis that operates on a graph metric, conceptually close to our constrained graph summarization.
Résumé de graphe (Graph Summarization)Graph Summarization
Liu et al. (2018) proposent la référence du domaine et distinguent quatre familles de méthodes : regroupement (grouping), compression de bits, simplification/sparsification, et approches basées sur l'influence. Leur constat central : il n'existe pas de définition universelle d'un « bon » résumé — sa qualité dépend de l'objectif visé. Shabani et al. (2024), plus récents, appliquent les graph neural networks au résumé de graphe et identifient le résumé orienté tâche (task-based) — produire un résumé adapté à un besoin précis plutôt que générique — comme direction de recherche ouverte. AURORA s'inscrit dans la famille regroupement/agrégation et répond directement à cette direction ouverte : notre critère de qualité du résumé est la préservation de l'équité, de la diversité et de l'inclusion.Liu et al. (2018) provide the field's reference survey and distinguish four families of methods: grouping, bit-compression, simplification/sparsification, and influence-based approaches. Their central finding: there is no universal definition of a "good" summary — its quality depends on the target objective. Shabani et al. (2024), more recent, apply graph neural networks to graph summarization and identify task-based summarization — producing a summary tailored to a specific need rather than a generic one — as an open research direction. AURORA falls within the grouping/aggregation family and directly answers this open direction: our summary quality criterion is the preservation of equity, diversity, and inclusion.
EDI dans les systèmes de recommandation & équité algorithmiqueEDI in recommender systems & algorithmic fairness
Yao & Huang (2017) montrent que la parité démographique est souvent inappropriée en filtrage collaboratif, car les préférences dépendent légitimement d'attributs sensibles comme le genre ; nous reprenons directement leur métrique de value unfairness pour notre ΔE. Leonhardt et al. (2018) apportent une preuve empirique d'un compromis direct entre diversité et équité utilisateur : augmenter la diversité agrégée accroît sensiblement la disparité entre utilisateurs. Zhao et al. (2024) passent en revue équité et diversité conjointement, classant les techniques en pré-, in- et post-traitement, et formulent le problème comme une optimisation multi-objectif sur un front de Pareto — une lecture différente de la nôtre, où l'onglet Pareto vérifie plutôt si chaque méthode satisfait un seuil EDI fixe, sans chercher à optimiser un compromis entre méthodes. Dong et al. (2023), le champ le plus proche d'AURORA, montrent que les graphes posent des défis d'équité absents des données i.i.d. (biais structurel par homophilie) ; parmi leurs techniques de mitigation, le edge rewiring est la seule à agir sur la structure du graphe comme AURORA — mais en ajoutant/retirant des arêtes, alors que nous réduisons le graphe par fusion de nœuds.Yao & Huang (2017) show that demographic parity is often inappropriate in collaborative filtering, since preferences legitimately depend on sensitive attributes like gender; we directly borrow their value unfairness metric for our ΔE. Leonhardt et al. (2018) provide empirical evidence of a direct trade-off between diversity and user fairness: increasing aggregate diversity noticeably increases disparity between users. Zhao et al. (2024) review fairness and diversity jointly, classifying techniques into pre-, in-, and post-processing, and frame the problem as a multi-objective optimization over a Pareto front — a different reading from ours, where the Pareto tab instead checks whether each method satisfies a fixed EDI threshold, without optimizing a trade-off between methods. Dong et al. (2023), the field closest to AURORA, show that graphs pose fairness challenges absent from i.i.d. data (structural bias through homophily); among their mitigation techniques, edge rewiring is the only one that acts on graph structure like AURORA — but by adding/removing edges, whereas we reduce the graph by merging nodes.
Choix social pour la recommandation équitable — SCRUF-D, le concurrent le plus procheSocial choice for fair recommendation — SCRUF-D, the closest competitor
Aird et al. (2023) introduisent SCRUF-D : chaque préoccupation d'équité est modélisée comme un agent qui vote (Borda, Copeland, Ranked Pairs) aux côtés du recommandeur de base pour produire le classement final. Une extension (Aird et al., 2024) généralise ce cadre à l'équité hétérogène — plusieurs notions d'équité combinées dans un seul système. C'est le travail conceptuellement le plus proche d'AURORA, et pourtant fondamentalement différent : SCRUF-D agit au moment de produire le classement final — un post-traitement — alors qu'AURORA agit en amont, sur la structure du graphe résumé, avant même que le classement ne soit calculé. Leur exploration approfondie de la voie post-hoc laisse la voie structurelle ouverte — c'est exactement le créneau qu'occupe ce travail. Nous ne l'implémentons pas comme référentiel expérimental : SCRUF-D exige une fonction d'utilité par préoccupation d'équité et un mécanisme de négociation inter-agents (vote de Borda, Copeland ou Ranked Pairs entre agents), à concevoir et calibrer séparément pour chacun de nos quatre corpus — une contribution méthodologique à part entière, distincte de notre protocole à métriques EDI fixes. Fair Re-rank, notre référentiel de post-traitement, reste comparable dans l'esprit (un ajustement du classement final sous contrainte d'équité) sans requérir cette architecture multi-agents ; une implémentation fidèle de SCRUF-D est laissée comme référentiel prioritaire pour un travail futur.Aird et al. (2023) introduce SCRUF-D: each fairness concern is modeled as an agent that votes (Borda, Copeland, Ranked Pairs) alongside the base recommender to produce the final ranking. An extension (Aird et al., 2024) generalizes this framework to heterogeneous fairness — several fairness notions combined in a single system. This is the work conceptually closest to AURORA, and yet fundamentally different: SCRUF-D acts at the moment of producing the final ranking — a post-processing step — whereas AURORA acts upstream, on the structure of the summarized graph, before the ranking is even computed. Their thorough exploration of the post-hoc path leaves the structural path open — exactly the niche this work occupies. We do not implement it as an experimental baseline: SCRUF-D requires a per-fairness-concern utility function and an inter-agent negotiation mechanism (Borda, Copeland, or Ranked Pairs voting among agents) that would need to be designed and calibrated separately for each of our four corpora — a methodological contribution in its own right, distinct from our fixed-EDI-metric evaluation protocol. Fair Re-rank, our post-processing baseline, remains comparable in spirit (adjusting the final ranking under a fairness constraint) without requiring this multi-agent architecture; a faithful SCRUF-D implementation is left as a priority baseline for future work.
À travers ces quatre champs, un constat se dégage : l'équité en recommandation a surtout été traitée par modification des entrées/sorties, par pré-/in-/post-traitement, ou par edge rewiring sur la structure du graphe ; le résumé de graphe, de son côté, a toujours optimisé la fidélité structurelle, le stockage ou la vitesse de requête. À notre connaissance, aucun travail existant ne fait de la préservation de l'équité, de la diversité et de l'inclusion un critère de qualité explicite d'un résumé de graphe — c'est précisément le manque qu'AURORA comble.Across these four fields, one finding stands out: fairness in recommendation has mostly been addressed through input/output modification, pre-/in-/post-processing, or edge rewiring on graph structure; graph summarization, for its part, has always optimized structural fidelity, storage, or query speed. To our knowledge, no existing work makes the preservation of equity, diversity, and inclusion an explicit quality criterion for a graph summary — this is precisely the gap AURORA fills.
Ce que nous avons appris — 4 corpus, un seul algorithmeWhat we learned — 4 corpora, one algorithm
| CorpusCorpus | Meilleur ΔEBest ΔE | Meilleur ILDBest ILD | Meilleure inclusion/frac_FBest inclusion/frac_F | Verdict globalOverall verdict |
|---|---|---|---|---|
| ML 100k | Fair Re-rank | Fair Re-rank | AURORA | AURORA (k=20) |
| ML 1M | Fair Re-rank | Fair Re-rank | Fair Re-rank | Fair Re-rank |
| libimseti | Fair Re-rank | AURORA | Condorcet | Aucun (écart persistant)None (persistent gap) |
| RMP | Avg Score / W.Borda / F.R. | Avg Score | AURORA | Compromis : AURORA (diversité) / F.R. (équité)Trade-off: AURORA (diversity) / F.R. (fairness) |
| OpenAlex | AURORA | Avg Score / F.R. | Avg Score / F.R. | AURORA |
Average Score exclu sur les 3 corpus user-side (raison détaillée ci-dessous) ; conservé sur RMP/OpenAlex. F.R. = Fair Re-rank. Sur OpenAlex, AURORA est aussi 2ᵉ/3ᵉ en ILD et frac_F, très proche d'Average Score/Fair Re-rank.Average Score excluded on the 3 user-side corpora (reason detailed below); kept on RMP/OpenAlex. F.R. = Fair Re-rank. On OpenAlex, AURORA is also 2nd/3rd on ILD and frac_F, very close to Average Score/Fair Re-rank.
Aucune méthode classique ne satisfait les 3 critères EDI simultanémentNo classical method satisfies all 3 EDI criteria simultaneously
L'Average Score produit une équité parfaite (ΔE≈0) mais une inclusion quasi-nulle sur les 3 corpus user-side (ML100k, ML1M, libimseti) — sur RMP et OpenAlex, où l'attribut sensible porte sur les items, son inclusion reste correcte (frac_F=0,40 et 0,20). Borda et Condorcet améliorent l'inclusion mais maintiennent un grand écart d'équité (ΔE≈0.45–1.30, sauf sur RMP où Borda reste bas à 0.065). Le Fair Re-rank améliore l'équité mais détruit la diversité sur RMP (ILD=0.276 contre 0.982 pour Average Score) ; sur libimseti, sa diversité (0.716) reste comparable à Borda (0.716) et légèrement en retrait de Condorcet (0.746), sans effondrement notable là-bas.Average Score produces perfect fairness (ΔE≈0) but near-zero inclusion on the 3 user-side corpora (ML100k, ML1M, libimseti) — on RMP and OpenAlex, where the sensitive attribute is on the items, its inclusion stays reasonable (frac_F=0.40 and 0.20). Borda and Condorcet improve inclusion but maintain a large fairness gap (ΔE≈0.45–1.30, except on RMP where Borda stays low at 0.065). Fair Re-rank improves fairness but destroys diversity on RMP (ILD=0.276 versus 0.982 for Average Score); on libimseti, its diversity (0.716) stays comparable to Borda (0.716) and slightly behind Condorcet (0.746), with no notable collapse there.
Notre méthode (coarsening) offre le meilleur équilibre équité+diversitéOur method (coarsening) offers the best fairness+diversity balance
MovieLens 100k k=20 : bat Borda, Condorcet et Weighted Borda sur les 4 critères simultanément. 943→471 super-nœuds (−50.1%), ILD=0.462, ΔE=0.285, inc_F=0.277.
MovieLens 1M : le tableau s'inverse — Fair Re-rank domine AURORA sur ΔE et ILD à la fois, à tout k testé, pas seulement sur la diversité. Un résultat propre à ce corpus, pas un désavantage général : AURORA bat toujours les 3 méthodes de vote classiques (Borda/W-Borda/Condorcet) sur ΔE et ILD simultanément, et reste compétitive en inclusion à k=20 (inc_F=0.294, quasi identique au meilleur, Weighted Borda à 0.295).
Rate My Professors : AURORA atteint ILD=0.808 (2ᵉ meilleure, proche d'Average Score 0.982) tout en portant frac_F à 60% (le plus haut, contre 20–50% pour les baselines) — ΔE=0.112, le plus élevé du tableau, derrière toutes les autres méthodes.
libimseti : seul corpus où le genre existe des deux côtés du graphe (notateurs et profils notés) — ΔE reste élevé pour les méthodes de vote et pour AURORA (Average Score et Fair Re-rank y échappent, ΔE=0.016 et 0.139), ce qui illustre empiriquement l'argument de Yao & Huang (2017) : la parité démographique n'est pas toujours un objectif approprié quand les préférences dépendent légitimement de l'attribut sensible (voir onglet libimseti.cz). AURORA garde néanmoins un net avantage de diversité sur les méthodes de vote.
Le message central : AURORA n'est pas uniformément meilleure — elle égale ou dépasse le re-ranking post-hoc (Fair Re-rank) sur les petits corpus et les cas item-side (RMP, OpenAlex), mais un corpus à forte base d'utilisateurs (ML1M) ou un domaine à préférences réciproques dépendantes de l'attribut sensible (libimseti) peut favoriser une approche post-hoc, ou révéler une limite structurelle du cadre à classement collectif unique.MovieLens 100k k=20: beats Borda, Condorcet and Weighted Borda on all 4 criteria simultaneously. 943→471 supernodes (−50.1%), ILD=0.462, ΔE=0.285, inc_F=0.277.
MovieLens 1M: the picture reverses — Fair Re-rank dominates AURORA on both ΔE and ILD, at every k tested, not just on diversity. A result specific to this corpus, not a general disadvantage: AURORA still beats all 3 classical voting methods (Borda/W-Borda/Condorcet) on ΔE and ILD simultaneously, and stays competitive on inclusion at k=20 (inc_F=0.294, nearly identical to the best, Weighted Borda at 0.295).
Rate My Professors: AURORA reaches ILD=0.808 (2nd best, close to Average Score's 0.982) while raising frac_F to 60% (the highest, versus 20–50% for the baselines) — ΔE=0.112, the highest in the table, behind every other method.
libimseti: the only corpus where gender exists on both sides of the graph (raters and rated profiles) — ΔE stays high for voting methods and for AURORA (Average Score and Fair Re-rank escape it, ΔE=0.016 and 0.139), which empirically illustrates Yao & Huang's (2017) argument: demographic parity is not always an appropriate goal when preferences legitimately depend on the sensitive attribute (see the libimseti.cz tab). AURORA nonetheless keeps a clear diversity advantage over voting methods.
The central message: AURORA is not uniformly better — it matches or beats post-hoc re-ranking (Fair Re-rank) on smaller corpora and item-side cases (RMP, OpenAlex), but a corpus with a large user base (ML1M) or a domain with reciprocal preferences dependent on the sensitive attribute (libimseti) can favor a post-hoc approach, or reveal a structural limitation of the single-collective-ranking framework.
Pourquoi l'ILD est l'axe le plus constant d'AURORAWhy ILD is AURORA's most consistent axis
L'avantage de diversité observé ci-dessus vient d'un mécanisme structurel plutôt que d'un réglage explicite : fusionner des super-nœuds similaires force le top-k à couvrir des zones différentes de l'espace des items — une diversification intrinsèque à la fusion, qui explique pourquoi elle tient face aux méthodes de vote non contraintes mais s'efface face à un re-ranking spécialisé comme Fair Re-rank.The diversity advantage seen above comes from a structural mechanism rather than an explicit setting: merging similar supernodes forces the top-k to cover different regions of the item space — a diversification intrinsic to the merge itself, which explains why it holds against unconstrained voting methods but fades against a specialized re-ranking method like Fair Re-rank.
Biais académique massif — OpenAlex confirme le pire casMassive academic bias — OpenAlex confirms the worst case
Seulement 19% d'autrices en AI/ML. Borda, Condorcet et Weighted Borda recommandent 0% de femmes (ΔE=1.23, ILD=0). C'est le biais le plus extrême observé dans nos 4 corpus, comparable aux études publiées sur les citations en Sciences. AURORA atteint ΔE=0.031 (−56% vs Average Score) tout en maintenant frac_F=19% — seule méthode à corriger ce biais extrême tout en préservant la représentation féminine.Only 19% female authors in AI/ML. Borda, Condorcet, and Weighted Borda recommend 0% women (ΔE=1.23, ILD=0). This is the most extreme bias observed across our 4 corpora, comparable to published studies on citations in the sciences. AURORA reaches ΔE=0.031 (−56% vs Average Score) while maintaining frac_F=19% — the only method that corrects this extreme bias while preserving female representation.
D'où vient le nom AURORAWhere the name AURORA comes from
La méthode résume (coarsening) un graphe biparti de préférences en super-nœuds, en garantissant que cette réduction préserve l'équité, la diversité et l'inclusion. C'est le principe qui traverse tout le site : chaque onglet, du Graphe à la Conclusion, mesure une facette de cette même idée.The method summarizes (coarsens) a bipartite preference graph into supernodes, while guaranteeing that this reduction preserves equity, diversity, and inclusion. This is the principle running through the whole site: every tab, from Graph to Conclusion, measures one facet of this same idea.
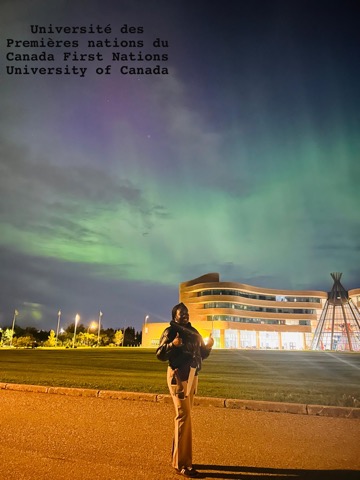
Le nom n'est pas qu'un acronyme technique. Pendant mon séjour de recherche à l'University of Regina, j'ai eu la chance d'assister à une soirée d'aurores boréales avec d'autres personnes, dans le ciel de la Saskatchewan — un moment magnifique. La plupart de ces photos ont été prises juste à côté du bâtiment incurvé de la First Nations University of Canada — le premier établissement universitaire contrôlé par des Premières Nations au Canada, fondé en 1976, dont l'architecture organique signée Douglas Cardinal évoque les paysages des Prairies — au bord du lac qui longe le campus. Ça m'a donné envie que le nom de la méthode y fasse écho : AURORA, comme ce phénomène qui rend visible une structure lumineuse là où le ciel semblait vide l'instant d'avant. Voici quelques photos prises ce soir-là.The name isn't just a technical acronym. During my research stay at the University of Regina, I had the chance to watch the northern lights one evening with other people, in the Saskatchewan sky — a beautiful moment. Most of these photos were taken right by the curved First Nations University of Canada building — the first Canadian university controlled by First Nations, founded in 1976, whose organic architecture by Douglas Cardinal echoes the Prairie landscape — along the lake that runs by campus. That made me want the method's name to echo it: AURORA, like that phenomenon that makes a luminous structure visible where the sky seemed empty a moment before. Here are a few photos taken that night.
Une aurore boréale ne modifie pas le ciel qu'elle traverse : elle rend visible une structure qui existait déjà, sous certaines conditions. AURORA suit la même logique — la méthode ne simplifie pas les préférences des utilisateurs en effaçant leurs différences, elle les réorganise sous contrainte d'équité, de diversité et d'inclusion. La structure d'origine reste là ; elle est simplement recomposée pour rester lisible.An aurora borealis doesn't change the sky it crosses: it makes visible a structure that already existed, under certain conditions. AURORA follows the same logic — the method doesn't simplify user preferences by erasing their differences, it reorganizes them under equity, diversity, and inclusion constraints. The original structure stays there; it's simply recomposed to remain legible.
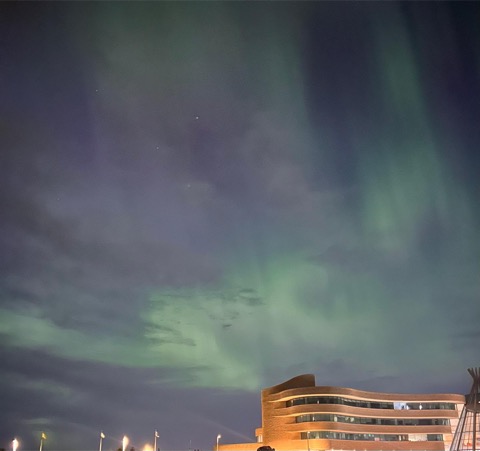
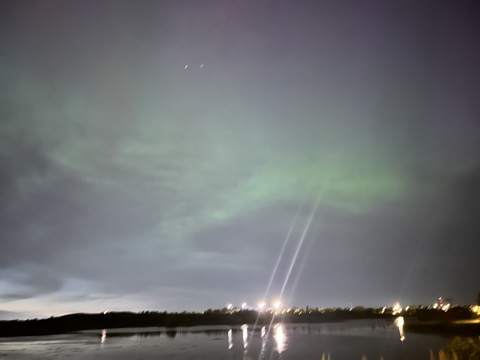
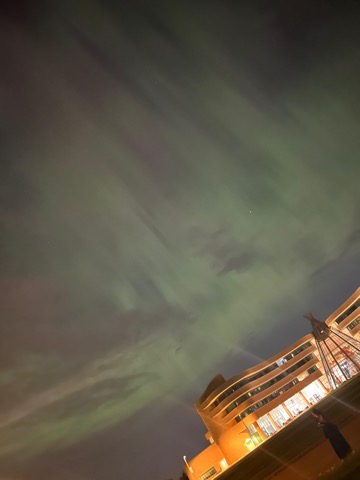
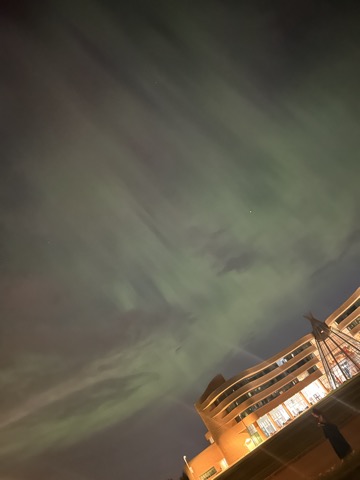
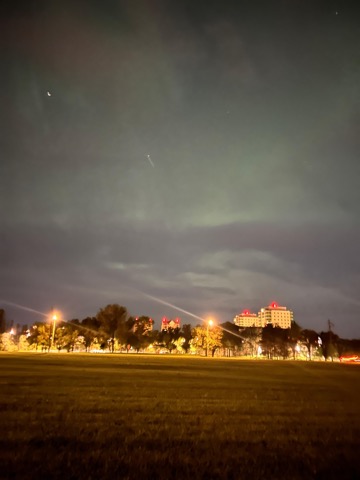
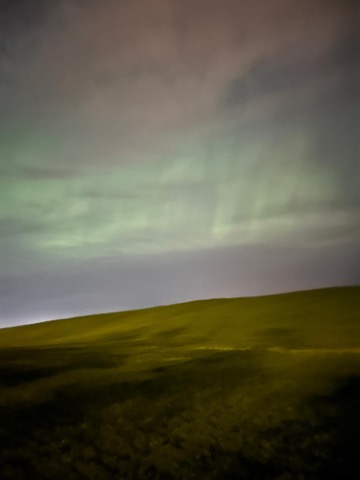
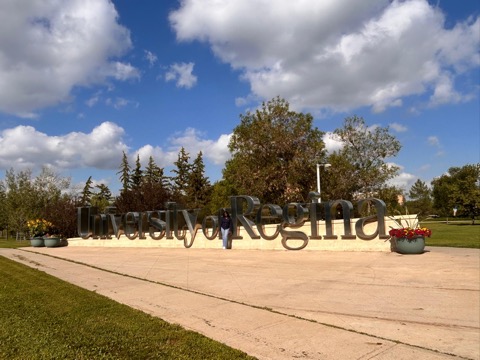
Cliquer sur une photo pour l'agrandir · flèches ← → ou clic pour naviguer · Échap pour fermer.Click a photo to enlarge it · arrows ← → or click to navigate · Esc to close.
- ↑ILD — diversité intra-liste (vers le haut)intra-list diversity (upward)
- → inc_M — inclusion du groupe masculininclusion of the male group
- ↓ ÉquitéFairness (1−ΔE) — proche de 1 = très équitableclose to 1 = very fair
- ← inc_F — inclusion du groupe féminininclusion of the female group
- Taille du cercle = k (petit→5, moyen→10, grand→20)Circle size = k (small→5, medium→10, large→20)
- Mode Les deux : ○ creux = 100k, ● plein = 1MBoth mode: ○ hollow = 100k, ● filled = 1M
- Lignes tiretées = trajectoire de scalabilité 100k → 1MDashed lines = 100k → 1M scalability trajectory
Toutes les expériences rapportées utilisent un unique passage déterministe sur l'intégralité du jeu de données. Pour vérifier que les écarts observés à k=10 ne sont pas un effet du tirage particulier des utilisateurs, nous ré-échantillonnons sans remise (90% de |U|, 30 répétitions) sur MovieLens 100k. Résultat : AURORA bat Borda et Condorcet sur ΔE dans 28/30 tirages et sur l'ILD dans 30/30 (Weighted Borda : 24/30 et 30/30), avec une variance faible (ΔE = 0,417 ± 0,035, ILD = 0,391 ± 0,004) — l'avantage sur les règles de vote classiques n'est pas un artefact du tirage unique du tableau principal. Fair Re-rank, à l'inverse, reste devant AURORA sur les deux métriques dans les 30/30 tirages, confirmant que son avantage sur ce corpus est lui aussi robuste. (Un premier essai avec un bootstrap classique — tirage avec remise — donnait des résultats trompeurs : ~63% des utilisateurs tirés sont alors des doublons exacts, ce qui avantage artificiellement les fusions de proches-identiques dans le coarsening. D'où le choix du sans-remise.)All reported experiments use a single deterministic pass over the full dataset. To check that the gaps observed at k=10 are not an artifact of the particular user draw, we resample without replacement (90% of |U|, 30 repetitions) on MovieLens 100k. Result: AURORA beats Borda and Condorcet on ΔE in 28/30 draws and on ILD in 30/30 (Weighted Borda: 24/30 and 30/30), with low variance (ΔE = 0.417 ± 0.035, ILD = 0.391 ± 0.004) — the advantage over the classical voting rules is not an artefact of the single draw in the main table. Fair Re-rank, conversely, stays ahead of AURORA on both metrics in all 30/30 draws, confirming its advantage on this dataset is likewise robust. (A first attempt with a classic bootstrap — sampling with replacement — gave misleading results: ~63% of drawn users are then exact duplicates, which artificially favors merging near-identical pairs in the coarsening. Hence the switch to sampling without replacement.)
Déplacez les curseurs pour parcourir les valeurs réellement testées (aucune interpolation ni simulation — chaque position correspond à un run mesuré). MovieLens 100k, k=20, θ=4.0.Move the sliders to browse the actually-tested values (no interpolation or simulation — each position corresponds to a measured run). MovieLens 100k, k=20, θ=4.0.
AxeY log. Lignes tiretées = ML-100k, lignes pleines = ML-1M. Weighted Borda légèrement plus lent que Borda (normalisation par groupe). Le temps d'AURORA croît régulièrement avec n_users (budget de fusion proportionnel à 50%).Y-axis log. Dashed lines = ML-100k, solid lines = ML-1M. Weighted Borda slightly slower than Borda (per-group normalization). AURORA's time grows steadily with n_users (50% proportional merge budget).
Taux de compression (super-nœuds / utilisateurs). Lignes tiretées = ML-100k, lignes pleines = ML-1M. Budget de fusion proportionnel à 50% : ratio constant sur toute la plage.Compression rate (supernodes / users). Dashed lines = ML-100k, solid lines = ML-1M. 50% proportional merge budget: constant ratio across the whole range.
Les 3 métriques EDI pour AURORA à k=10 : ΔE (vert, 1−ΔE affiché), ILD (bleu), inc_F (ambre). Lignes tiretées = ML-100k, lignes pleines = ML-1M. Une valeur élevée est meilleure pour les trois métriques.All 3 EDI metrics for AURORA at k=10: ΔE (green, 1−ΔE shown), ILD (blue), inc_F (amber). Dashed lines = ML-100k, solid lines = ML-1M. A higher value is better for all three metrics.
Zone en pointillés = idéale (ΔE bas + ILD haut). Lignes reliant chaque méthode = trajectoire 100k→1M : AURORA s'en rapproche nettement à 1M, mais Fair Re-rank reste devant sur ce corpus.Dashed zone = ideal (low ΔE + high ILD). Lines connecting each method = 100k→1M trajectory: AURORA moves noticeably closer at 1M, but Fair Re-rank stays ahead on this corpus.
Les 4 dernières colonnes sont Δ = valeur 1M − valeur 100k. Comme un ΔE plus bas est meilleur, vert sur ΔΔE = négatif = l'équité s'améliore à 1M ; rouge = positif = elle se dégrade. ILD, inc_F et inc_M suivent la logique inverse (plus haut = meilleur) : vert = positif = amélioration ; rouge = négatif = dégradation.The last 4 columns are Δ = 1M value − 100k value. Since a lower ΔE is better, green on ΔΔE = negative = fairness improves at 1M; red = positive = it worsens. ILD, inc_F, and inc_M follow the opposite logic (higher = better): green = positive = improvement; red = negative = worsening.
Barres claires = 100k · Barres pleines = 1M · Échelle logarithmique.Light bars = 100k · Solid bars = 1M · Logarithmic scale.
Le budget de fusion proportionnel (50 % de |U|) reste exactement constant à toutes les échelles testées (250 → 3 020 super-nœuds sur 500 → 6 040 utilisateurs, ratio = 0,500 partout) : le mécanisme de compression ne dérive pas avec la taille du corpus. Le temps d'exécution d'AURORA croît en revanche plus vite que linéairement avec n_users (×30 pour ×12 utilisateurs entre 500 et 6 040, exposant empirique ≈ 1,36), et l'écart avec les règles de vote se creuse avec l'échelle : environ 12× plus lente que Borda à 500 utilisateurs, environ 29× à 6 040 — un coût qui reste de moins d'une minute (37 s) sur le plus grand corpus testé, acceptable pour un calcul hors ligne mais à surveiller au-delà. Sur ΔE et ILD, AURORA est stable au-delà de ~1 000 utilisateurs (ΔE ≈ 0,21–0,26, ILD ≈ 0,43–0,45), sans tendance nette d'amélioration ni de dégradation ; les valeurs plus dispersées en dessous de 1 000 utilisateurs reflètent la taille réduite de l'échantillon, pas un effet de l'algorithme.The proportional merge budget (50% of |U|) stays exactly constant at every scale tested (250 → 3,020 supernodes across 500 → 6,040 users, ratio = 0.500 throughout): the compression mechanism does not drift with corpus size. AURORA's runtime, however, grows faster than linearly with n_users (×30 for a ×12 increase in users between 500 and 6,040, an empirical exponent ≈ 1.36), and the gap with the voting rules widens with scale: roughly 12× slower than Borda at 500 users, roughly 29× at 6,040 — a cost that stays under a minute (37s) on the largest corpus tested, acceptable for offline computation but worth watching beyond that. On ΔE and ILD, AURORA is stable above ~1,000 users (ΔE ≈ 0.21–0.26, ILD ≈ 0.43–0.45), with no clear improving or degrading trend; the more scattered values below 1,000 users reflect the smaller sample size, not an algorithmic effect.
Limite : ce balayage n'a été mesuré qu'à k=10, θ=4.0. La stabilité du temps d'exécution est cohérente avec le tableau d'efficacité computationnelle, où le temps d'AURORA varie peu avec k (3,79–4,04 s sur MovieLens 100k pour k∈{5,10,20}) — l'extrapoler aux autres k est donc raisonnable. En revanche, la stabilité de ΔE et ILD à travers les échelles n'a été vérifiée qu'à ce seul k ; rien ne garantit qu'elle tienne à k=5 ou k=20, puisque ΔE et ILD sont, eux, sensibles à k sur chaque jeu de données testé ailleurs sur ce site. C'est une limite ouverte, pas une généralisation établie.Limitation: this sweep was only measured at k=10, θ=4.0. The runtime stability is consistent with the computational-efficiency table, where AURORA's runtime varies little with k (3.79–4.04s on MovieLens 100k for k∈{5,10,20}) — so extrapolating it to other k values is reasonable. The stability of ΔE and ILD across scale, however, has only been checked at this single k; nothing guarantees it holds at k=5 or k=20, since ΔE and ILD are themselves sensitive to k on every dataset tested elsewhere on this site. This is an open limitation, not an established generalization.
ΔE > 1.0 pour Borda/Condorcet : les rateurs M et F ont des patterns de notation distincts (voir tableau croisé ci-dessous) — inédit sur MovieLens, où le genre n'influence pas structurellement la note d'un film.ΔE > 1.0 for Borda/Condorcet: M and F raters have distinct rating patterns (see the cross-table below) — unlike MovieLens, where gender doesn't structurally influence a movie's rating.
Notre méthode garde un net avantage de diversité sur les méthodes de vote (Borda, Condorcet, Weighted Borda) — même avantage relatif que sur MovieLens.Our method keeps a clear diversity advantage over voting methods (Borda, Condorcet, Weighted Borda) — the same relative advantage as on MovieLens.
Sur libimseti, les patterns de notation diffèrent significativement selon le genre du notateur et celui du profil noté (12 258 052 notes exploitables, genre connu des deux côtés) :On libimseti, rating patterns differ significantly depending on the rater's gender and that of the rated profile (12,258,052 usable ratings, gender known on both sides):
| Notateur → NotéRater → Rated | Note moyenneAverage rating | Nb de notesNumber of ratings |
|---|---|---|
| F → M | 6.92 | 7 099 688 |
| M → F | 5.48 | 3 232 064 |
| F → F | 5.14 | 1 243 590 |
| M → M | 4.46 | 682 710 |
Pourquoi ΔE reste élevé pour les méthodes de vote et pour AURORA (Average Score et Fair Re-rank y échappent) ?Why does ΔE stay high for voting methods and for AURORA (Average Score and Fair Re-rank escape it)?
libimseti est le seul des 4 corpus étudiés où l'attribut sensible (genre) existe des deux côtés du graphe biparti — notateurs et profils notés. Un classement collectif unique, partagé par tout le monde, ne peut structurellement pas produire la même satisfaction pour les deux groupes de notateurs quand leurs notes elles-mêmes suivent des distributions aussi différentes selon la paire de genres.libimseti is the only one of the 4 studied corpora where the sensitive attribute (gender) exists on both sides of the bipartite graph — raters and rated profiles. A single collective ranking, shared by everyone, cannot structurally produce the same satisfaction for both rater groups when their own ratings follow such different distributions depending on the gender pair.
Lien avec la littératureLink to the literature
Ce résultat illustre empiriquement l'argument de Yao & Huang (2017, section 3.3) : la parité démographique (viser ΔE≈0) n'est pas toujours un objectif approprié en recommandation lorsque les préférences des groupes dépendent légitimement de l'attribut sensible étudié. Un ΔE élevé sur libimseti ne signale donc pas nécessairement une injustice algorithmique, mais peut refléter une différence de préférence structurelle du domaine — contrairement à MovieLens ou Rate My Professors, où rien ne justifie a priori que le genre influence l'appréciation d'un film ou la qualité perçue d'un cours.This result empirically illustrates Yao & Huang's (2017, section 3.3) argument: demographic parity (targeting ΔE≈0) is not always an appropriate goal in recommendation when group preferences legitimately depend on the sensitive attribute studied. A high ΔE on libimseti therefore does not necessarily signal algorithmic injustice, but may reflect a structural preference difference of the domain — unlike MovieLens or Rate My Professors, where nothing a priori justifies gender influencing how a movie is enjoyed or a course's perceived quality.
Notre méthode (AURORA)Our method (AURORA)
Le budget de fusion proportionnel n'améliore pas ΔE sur ce corpus (résultat stable sur une plage de 30 à 60% de compression testée), ni un resserrement de la tolérance de contrainte — cohérent avec la lecture ci-dessus : ce n'est pas un problème de réglage, mais une limite structurelle du cadre à classement collectif unique sur un domaine où la préférence est intrinsèquement différenciée par genre. AURORA conserve néanmoins un avantage en diversité (ILD) sur les méthodes de vote (Borda, Condorcet) à k=10 et k=20 — à k=5, elle leur est tout juste égale (voir le tableau ci-dessus pour le détail par k).The proportional merge budget does not improve ΔE on this corpus (result stable over a 30–60% compression range tested), nor does tightening the constraint tolerance — consistent with the reading above: this is not a tuning problem, but a structural limitation of the single-collective-ranking framework on a domain where preference is intrinsically differentiated by gender. AURORA nonetheless retains a diversity advantage (ILD) over voting methods (Borda, Condorcet) at k=10 and k=20 — at k=5, it is merely tied with them (see the table above for the per-k breakdown).
ΔE reste faible pour toutes les méthodes : pas de biais de genre systématique dans les évaluations étudiantes sur RMP.ΔE stays low for all methods: no systematic gender bias in student evaluations on RMP.
Sur RMP, quelques "super-profs" concentrent des milliers de notes. Le vote par Borda les place systématiquement en tête pour tous les cours → les top-k se ressemblent → diversité effondrée (ILD=0.27 à k=10, 0.20 à k=20). C'est l'effet de popularité classique en systèmes de recommandation.On RMP, a handful of "super-professors" concentrate thousands of ratings. Borda voting systematically places them at the top for every course → the top-k lists all look alike → diversity collapses (ILD=0.27 at k=10, 0.20 at k=20). This is the classic popularity effect in recommender systems.
Coarsening : 1 981 cours → 990 super-nœuds (budget 50%, constant quel que soit k). À k=10 : ILD=0.808 — profs diversifiés et pertinents. ΔE=0.112 (le plus élevé du tableau à ce k), frac_F=60% (légère sur-représentation des profs F). Ce compromis équité/diversité varie avec k — voir le tableau ci-dessus pour k=5 et k=20.Coarsening: 1,981 courses → 990 supernodes (50% budget, constant regardless of k). At k=10: ILD=0.808 — diverse and relevant professors. ΔE=0.112 (the highest in the table at this k), frac_F=60% (slight over-representation of F professors). This fairness/diversity trade-off varies with k — see the table above for k=5 and k=20.
En AI/ML, seulement 19% des auteurs avec genre connu sont des femmes. Borda recommande systématiquement les auteurs les plus prolifiques — tous masculins. Résultat : 0% d'autrices dans le top-k pour toutes les venues → ΔE = 1.23, ILD = 0. C'est le biais académique de genre le plus fort observé dans nos 4 corpus. À k=20, l'effet s'atténue un peu (ΔE=0.91, 5% d'autrices) — la liste s'allonge assez pour inclure quelques femmes par nécessité.In AI/ML, only 19% of authors with known gender are women. Borda systematically recommends the most prolific authors — all men. Result: 0% female authors in the top-k for every venue → ΔE = 1.23, ILD = 0. This is the strongest academic gender bias observed across our 4 corpora. At k=20, the effect eases slightly (ΔE=0.91, 5% female authors) — the list grows long enough to include a few women out of necessity.
Ce résultat confirme les études sur le biais de genre dans les citations (Dworkin et al. 2020, Caplar et al. 2017). Un système de recommandation basé sur le vote (Borda) amplifie structurellement ce biais. Notre coarsening vise à briser cette dynamique en fusionnant des venues similaires jusqu'à améliorer la diversité des auteurs recommandés.This result confirms published studies on gender bias in citations (Dworkin et al. 2020, Caplar et al. 2017). A voting-based recommender system (Borda) structurally amplifies this bias. Our coarsening aims to break this dynamic by merging similar venues until the diversity of recommended authors improves.
↑DiversitéDiversity (ILD) — diversité des items recommandés [0→1]diversity of recommended items [0→1]
→ ÉquitéFairness (1−ΔE) — 1 = ΔE nul (parfaitement équitable). ΔE est inversé pour que "plus = mieux" soit cohérent.1 = ΔE zero (perfectly fair). ΔE is inverted so that "more = better" stays consistent.
←GenreGender (frac_F norm.) — proportion de femmes dans le top-k, normalisée par rapport à la meilleure valeur observée.proportion of women in the top-k, normalized against the best observed value.
Ce graphique compare a posteriori six méthodes déjà calculées à des seuils fixes — il ne décrit pas ce qu'AURORA optimise en interne, et volontairement il n'y a pas de ligne de compromis à atteindre entre méthodes. AURORA ne cherche jamais à faire un compromis entre ΔE et ILD : son problème formel (mémoire, éq. IV.9) est de minimiser la perte structurelle L(G,G') du coarsening sous contrainte que ΔE, l'ILD et l'inclusion restent dans une tolérance (ε_E, ε_D, ε_I) par rapport au graphe original — pas de maximiser ou d'arbitrer entre ces métriques. Qu'un point AURORA tombe ou non dans la zone idéale est donc une observation empirique sur le résultat, pas une caractérisation de sa fonction objectif.This chart compares six already-computed methods after the fact against fixed thresholds — it does not describe what AURORA optimizes internally, and deliberately there is no trade-off line to reach between methods. AURORA never trades off ΔE against ILD: its formal problem (thesis, eq. IV.9) is to minimize the coarsening's structural loss L(G,G') subject to the constraint that ΔE, ILD, and inclusion stay within a tolerance (ε_E, ε_D, ε_I) of the original graph — not to maximize or arbitrate between these metrics. Whether or not an AURORA point falls in the ideal zone is thus an empirical observation about the outcome, not a characterization of its objective function.
Taille du point = inclusion (inc_F, ou frac_F pour RMP/OpenAlex) : un point minuscule signale une inclusion quasi nulle, même bien placé sur ΔE et ILD.Point size = inclusion (inc_F, or frac_F for RMP/OpenAlex): a tiny point signals near-zero inclusion, even when well-placed on ΔE and ILD.